Como medir a visibilidade de uma marca nas IAs: o método, passo a passo
Medir visibilidade em IA é contar, em centenas de respostas, com que frequência a marca aparece. Quais perguntas fazer, em que ambiente, quantas vezes e como ler a margem de erro.
Parte do tema Medição de visibilidade em IA →
Medir a visibilidade de uma marca nas IAs é contar em quantas respostas, de um conjunto grande, ela aparece. O método tem cinco decisões: quais perguntas fazer, em qual ambiente, quantas vezes, como extrair as marcas e como ler a margem de erro. Com 1.000 respostas por pergunta, a presença de cada marca é medida com margem de até ±3,1 pontos percentuais, segundo o estudo metodológico FA-MET-01, “Como medir o que uma IA recomenda”, publicado pela First Answer em abril de 2026, com 7.000 chamadas na interface do ChatGPT.
Este guia junta o que já foi medido sobre o assunto. Ele não substitui uma ferramenta, mas dá a régua para avaliar qualquer número de “visibilidade em IA” que aparecer na sua frente, inclusive os que eu publico. Uma declaração antes: sou co-fundador e CTO da First Answer, que fez os estudos FA-MET citados aqui.
Por que um print não mede nada
A mesma pergunta, feita duas vezes à mesma IA, traz marcas diferentes. A SparkToro testou isso com 600 voluntários, que rodaram 12 perguntas no ChatGPT, no Claude e na IA do Google 2.961 vezes, entre novembro e dezembro de 2025. Conclusão de Rand Fishkin: a chance de o ChatGPT ou a IA do Google darem a mesma lista de marcas em duas respostas é menor que 1 em 100. Na mesma ordem, perto de 1 em 1.000.
Isso não quer dizer que não haja padrão. Quer dizer que o padrão só aparece em escala. Expliquei os motivos da variação em por que a IA dá uma resposta diferente a cada pergunta. Aqui o assunto é o que fazer com ela.
O que medir: presença, posição e citação
- Presença: a porcentagem de respostas em que a marca aparece. É a métrica principal, porque é a que converge para um valor estável quando a amostra cresce.
- Posição: em que ordem a marca aparece. É bem mais instável. No estudo da SparkToro, o hospital City of Hope apareceu em 69 de 71 respostas do ChatGPT (97%), mas foi o primeiro citado em só 25 delas.
- Citação: quando a resposta traz link para uma página. Mostra quais fontes a IA usou, o que é diferente de mencionar a marca no texto.
- Share of voice: a fatia das menções da categoria que fica com cada marca. Sai da mesma contagem da presença.
Passo 1: escolha as perguntas que o seu cliente faria
Escreva as perguntas como um consumidor digitaria, sem o nome da sua marca. É o que os estudos FA-MET fazem: uma pergunta fixa por experimento, na linguagem de quem está escolhendo um produto.
Uma pergunta só não representa uma categoria, porque as pessoas perguntam de jeitos muito diferentes. A SparkToro pediu a 142 pessoas que escrevessem uma pergunta sobre fones de ouvido, e a similaridade semântica média entre elas foi de 0,081, perto de zero. Monte um conjunto de perguntas por tema, cobrindo as formulações que o seu cliente usa.
Passo 2: declare o ambiente
O mesmo modelo responde coisas diferentes conforme o lugar onde a pergunta é feita. O segundo estudo da série, o FA-MET-02, “API ou interface, eis a questão”, fez a mesma pergunta 1.000 vezes pela API do ChatGPT, o acesso usado por desenvolvedores, e 1.000 vezes pela interface que o consumidor usa, no mesmo dia e com a mesma ferramenta de busca:
- 12 das 15 marcas mais relevantes tiveram diferença significativa entre os dois ambientes.
- Uma marca foi de 11,1% na API para 92,6% na interface. Outra, de 66,5% para 6,4%.
- Das 56 marcas observadas, 64% apareceram em só um dos ambientes.
Medir pela API é mais barato e mais fácil de automatizar, mas mede outro sistema. Se a pergunta é “o que o consumidor vê”, a medição precisa ser feita onde ele está. E cada IA é um ambiente à parte: ChatGPT, Gemini, Perplexity e as respostas de IA do Google precisam ser medidos um a um.
Passo 3: defina o tamanho da amostra pelo objetivo
A precisão depende só do número de chamadas e da presença da própria marca. A tabela abaixo é do FA-MET-01, com margens para 95% de confiança:
| Objetivo | Chamadas por pergunta | O que entrega |
|---|---|---|
| Diagnóstico inicial | 100 a 200 | Se o mercado é concentrado e quem está no topo (±7 a 10 pp) |
| Hierarquia visível | 1.000 | Presença com até ±3 pp; ordem confiável entre marcas separadas por mais de ~6 pp |
| Mudança entre rodadas | 1.000 por rodada | Mudanças acima de ~4,4 pp (presença perto de 50%) se separam do ruído |
| Precisão de ±1 pp | ~9.600 | Presença com ±1 pp em qualquer nível |
| Cauda até 0,1% | ~3.000 | 95% de chance de ver ao menos uma vez cada marca com 0,1% de presença |
O estudo testou se a conta vale na prática. Ao estender um experimento de 1.000 para 5.000 chamadas, nenhuma das dez marcas principais saiu da margem prevista, e a maior variação foi de 2,9 pontos.
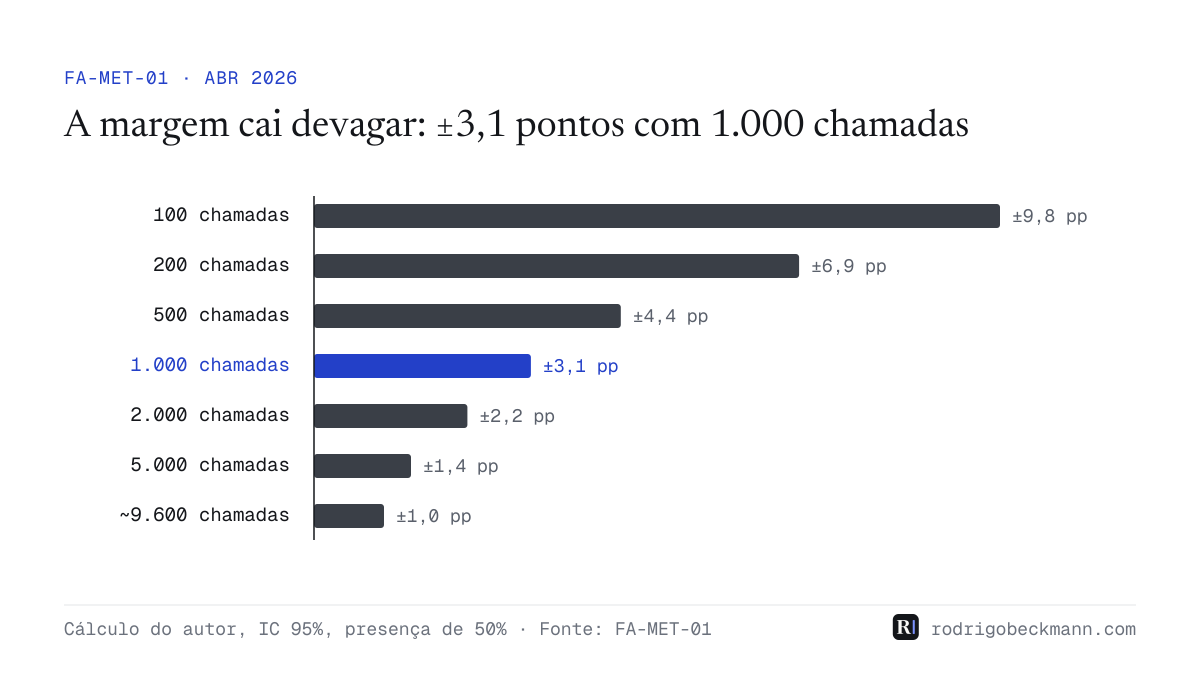
A curva explica por que não vale a pena perseguir precisão demais. Para dividir a margem por dois, é preciso quadruplicar as chamadas: sair de ±3,1 para ±1 ponto custa quase dez vezes mais coleta.
Passo 4: colete em conversas novas e normalize as marcas
Cada chamada precisa ser independente. Nos estudos FA-MET, cada pergunta foi feita numa conversa nova, para que a resposta anterior não influencie a seguinte.
Depois vem a extração: identificar todas as marcas citadas em cada resposta e juntar as variações de nome na marca-mãe. Sem essa normalização, “Marca X” e “Marca X Brasil” viram duas marcas, e a presença das duas sai subestimada.
Passo 5: leia a margem antes de ler o número
Toda presença medida vem com um intervalo. Com 1.000 chamadas, uma marca medida em 50% está, com 95% de confiança, entre cerca de 47% e 53%. Os estudos FA-MET usam o intervalo de Wilson, que se comporta bem também perto de 0% e de 100%.
Duas consequências práticas:
- Diferenças pequenas não são mudança. Entre duas rodadas de 1.000 chamadas, variações abaixo de ~4 pontos devem ser tratadas como ruído.
- A cauda engana. No experimento de 5.000 chamadas, 29% das marcas raras que apareceram nas primeiras 1.000 não voltaram nas 4.000 seguintes. Uma marca que apareceu uma ou duas vezes não está “presente”.
Passo 6: complete com o que o Google mostra
Desde 3 de junho de 2026, o Search Console tem um relatório de IA generativa com as impressões do site nos AI Overviews, no AI Mode e no Discover. É o único dado oficial de uma plataforma, mas cobre só o Google, mostra impressões e não cliques, e começou pelo Reino Unido, sem data para o Brasil. Detalhei o relatório neste post.
As duas fontes se completam. O Search Console diz quantas vezes páginas do seu site apareceram. A amostragem diz se a sua marca é recomendada, inclusive quando a IA não linka para você.
O que esta medição não mostra
- O modelo exato. Na interface do ChatGPT, sem login, não dá para fixar nem registrar qual modelo respondeu.
- A composição em outro contexto. A regularidade estatística deve valer para outros modelos e ambientes. Quais marcas sobem ou descem, não necessariamente.
- O usuário logado. Os estudos FA-MET não testaram histórico, memória ou personalização.
- O porquê. A contagem diz quem aparece, não por que aparece. Para isso é preciso olhar as fontes citadas.
Como avaliar qualquer número de visibilidade em IA
Antes de acreditar num relatório, inclusive num meu, peça quatro informações:
- Quantas respostas foram coletadas por pergunta e por IA.
- Em qual ambiente: API ou interface, logado ou não.
- Qual a margem de erro de cada número.
- Quais perguntas foram usadas e quem as escreveu.
São as mesmas perguntas que listei no guia para avaliar um especialista em GEO, e boa parte delas virou cláusula no padrão de GEO publicado na China. Um número sem essas quatro respostas é uma anedota com formatação de dado.
A régua em uma frase
Visibilidade em IA é uma porcentagem com margem, não uma posição: muitas perguntas, ambiente declarado, amostra do tamanho do objetivo e nenhuma conclusão tirada de uma resposta só.
Perguntas frequentes
Como saber se minha marca aparece no ChatGPT?
Fazendo a mesma pergunta muitas vezes, cada uma numa conversa nova, e contando em quantas respostas a marca aparece. Uma pergunta só não basta: segundo a SparkToro, a chance de o ChatGPT repetir a mesma lista de marcas em duas respostas é menor que 1 em 100.
Quantas vezes preciso rodar um prompt para medir a presença de uma marca?
Depende do objetivo. Segundo o estudo metodológico FA-MET-01, de abril de 2026, com 7.000 chamadas na interface do ChatGPT, 100 a 200 chamadas mostram se o mercado é concentrado e quem está no topo, com margem de ±7 a 10 pontos; 1.000 chamadas medem cada marca com até ±3,1 pontos; ±1 ponto pede cerca de 9.600.
Medir pela API do ChatGPT dá o mesmo resultado que medir pela interface?
Não. No estudo FA-MET-02, com a mesma pergunta e a mesma ferramenta de busca, 12 das 15 marcas mais relevantes tiveram diferença significativa entre a API e a interface, e 64% das 56 marcas observadas apareceram em só um dos dois ambientes.
O que é share of voice em IA?
É a fatia das menções de uma categoria que fica com cada marca, num conjunto de respostas de IA. Ele deriva da mesma contagem da presença, que é a porcentagem de respostas em que a marca aparece, e herda as mesmas exigências: amostra grande, ambiente declarado e margem de erro.
O Google Search Console mede a visibilidade nas respostas de IA?
Em parte. O relatório de IA generativa, lançado em 3 de junho de 2026, mostra impressões do site nos AI Overviews, no AI Mode e no Discover. Não mostra cliques, posição nem concorrentes, e não cobre ChatGPT, Perplexity ou o app do Gemini.
Fontes
- FA-MET-01: Como medir o que uma IA recomenda — First Answer, 30 abr 2026 · fonte principal
- FA-MET-02: API ou interface, eis a questão — First Answer, 30 abr 2026
- NEW Research: AIs are highly inconsistent when recommending brands or products; marketers should take care when tracking AI visibility — SparkToro, 28 jan 2026
- Introducing Search Generative AI performance reports in Search Console — Google Search Central Blog, 03 jun 2026
